免费 · 开源 · 离线
把声音变成文字,就在你的电脑上完成
VoxSpica 用 VOSK 在本地把麦克风语音和音频文件转成文字。声音不会离开你的电脑:没有云端、没有账号、没有订阅,断网也能继续工作。
Windows 10/11 x64 · 每种语言一个安装包 · 语言模型已内置
- 音频不离开你的电脑
- 无需账号、付费或广告
- 拔掉网线也能用
- Apache-2.0,源码在 GitHub
为什么选它
不附带任何条件的听写
云端听写需要订阅、需要网络,还要交出你的声音。VoxSpica 用开源引擎和只需下载一次的模型,在你自己的处理器上完成识别。
离线是设计出来的
识别由本地进程完成,引擎是 VOSK(Kaldi ASR)。模型下载之后,产品里没有任何网络请求——拔掉网线,它照样在转写。
隐私是结构决定的
根本没有可以上传音频的地址。录音、文字和历史都留在你的用户目录里,历史数据库就是磁盘上一个 SQLite 文件。
实时转写
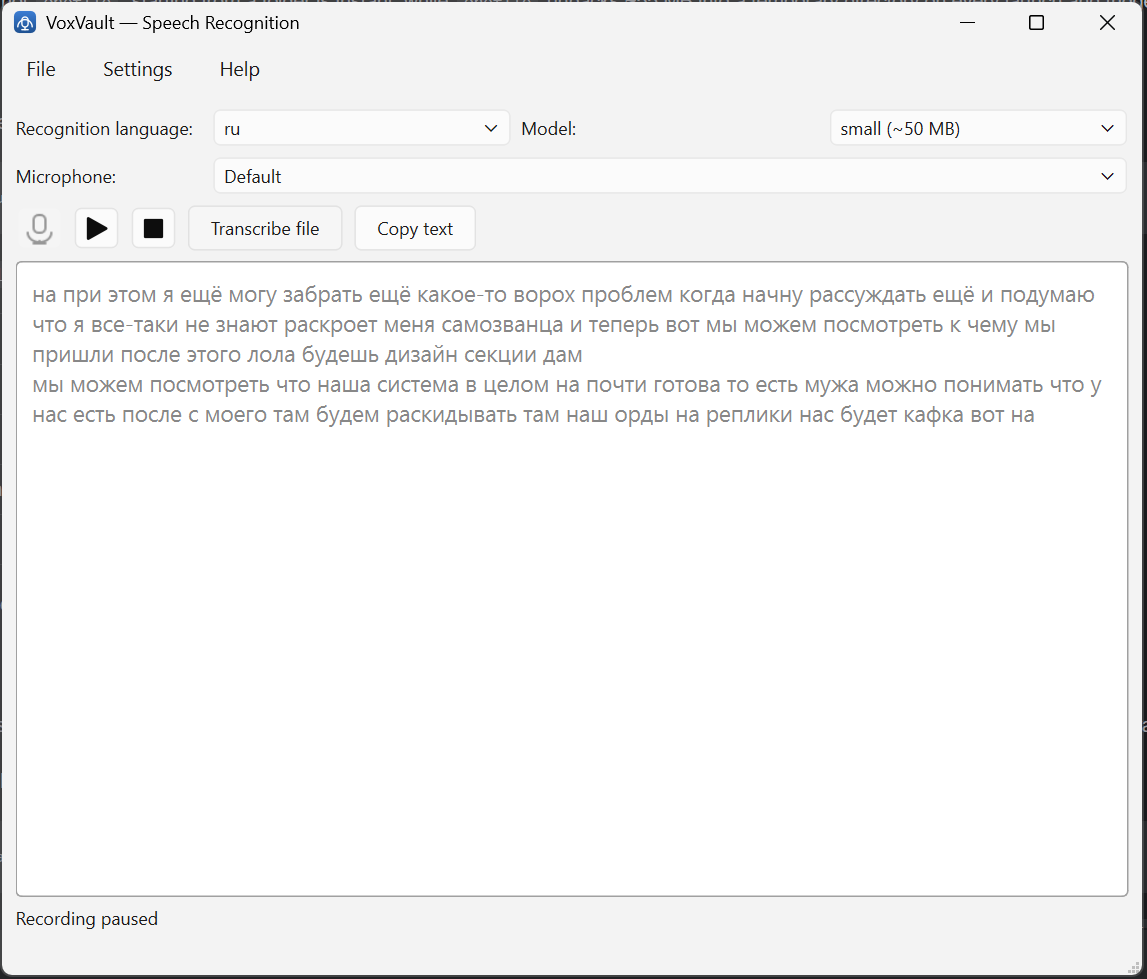
边说边出字。可以暂停、继续,也可以停止并保留结果。模型在后台预热,所以录音按钮立刻就能响应。
既能录,也能转文件
转写录音文件(WAV,mp3/m4a/ogg 需 ffmpeg),或者实时麦克风。自动语言检测会为文件挑出最合适的已安装模型。
真正有用的历史
每次识别都会存进 SQLite:日期、语言、模型大小、设备、时长和正文。在程序里搜,或直接在命令行搜。
窗口和命令行都有
窗口用来听写,命令行用来写脚本,共用同一个设置文件和同一个历史。会议、语音备忘、文件——让命令行去忙。
一个文件就能跑
便携版就是一个可执行文件,启动时自己解包依赖。不需要装 Python,也不需要装别的东西。
对准确率保持诚实
小模型够用,大模型明显更好但加载更久。VoxSpica 会说清差别在哪,而不是给所有语言套一个数字。
工作方式
从声音到文字,三步
装对应语言的版本
每个安装包都已本地化,并且内置了对应语言的小模型:第一次启动就能离线使用,不用下载。
按下录音,开始说话
选择识别语言和模型大小。模型在后台加载时,窗口已经可以用了。
拿到文字
看着文字实时出现,然后复制、另存到录音旁边,或者稍后在历史里搜索到它。
语言
33 种识别语言,9 种界面语言
识别语言和界面语言是分开的:可以用一种语言口述,同时让窗口说另一种。识别语言都有小模型;大模型则取决于 VOSK 是否发布。
- العربيةar
- Português (BR)br
- Catalàca
- 中文(普通话)cn
- Češtinacs
- Deutschde
- Ελληνικάel-gr
- English (India)en-in
- English (US)en-us
- Esperantoeo
- Españoles
- فارسیfa
- Françaisfr
- ગુજરાતીgu
- हिन्दीhi
- Italianoit
- 日本語ja
- ქართულიka
- 한국어ko
- Кыргызчаky
- Қазақшаkz
- Nederlandsnl
- Polskipl
- Portuguêspt
- Русскийru
- Svenskasv
- తెలుగుte
- Тоҷикӣtg
- Tagalogtl-ph
- Türkçetr
- Українськаuk
- Oʻzbekchauz
- Tiếng Việtvn
小 + 大 · 小模型 · 大模型
界面语言
- English
- Русский
- Українська
- Беларуская
- Deutsch
- Français
- Español
- Italiano
- 简体中文
共九种:英语、俄语、乌克兰语、白俄罗斯语、德语、法语、西班牙语、意大利语、简体中文。其中七种有本地化安装包——InstallShield 没有乌克兰语和白俄罗斯语的安装向导字符串,所以这两种只有程序支持,没有安装包。
每个安装包里有什么
本地化安装向导、对应语言的程序本体,以及该语言现成的小模型——所以每个安装包约 100 MB,而不是 55 MB。
- 小模型
- 29
- 大模型
- 26
下载
选你的语言,模型已经装在包里
七个安装包,各自有自己的语言,也各自内置了该语言的小模型。装上、启动、开始听写:第一次不需要下载。
安装包
- English100.5 MBVoxSpica-0.1.3-en-setup.exe内置 vosk-model-small-en-us-0.15下载
- Русский105.2 MBVoxSpica-0.1.3-ru-setup.exe内置 vosk-model-small-ru-0.22下载
- Deutsch105.4 MBVoxSpica-0.1.3-de-setup.exe内置 vosk-model-small-de-0.15下载
- Français101.6 MBVoxSpica-0.1.3-fr-setup.exe内置 vosk-model-small-fr-0.22下载
- Español99.2 MBVoxSpica-0.1.3-es-setup.exe内置 vosk-model-small-es-0.42下载
- Italiano108.7 MBVoxSpica-0.1.3-it-setup.exe内置 vosk-model-small-it-0.22下载
- 简体中文103.3 MBVoxSpica-0.1.3-zh-setup.exe内置 vosk-model-small-cn-0.22下载
或者用便携版
zip 里只有一个可执行文件:没有安装向导,也没有内置模型——程序第一次启动时会问界面语言并下载对应模型。下载量最小,想先试试就选它。
VoxSpica-0.1.3-win64.zip61.0 MB0.1.3
常见问题
装之前值得问的问题
我的声音真的留在本机吗?
是的。识别由本地进程完成——VOSK,一套开源的 Kaldi 构建——跑在你的 CPU 上。产品里没有上传地址、没有遥测、没有账号。断网后照常工作。
支持哪些 Windows 版本?
Windows 10 和 11,64 位。没有 32 位版本,macOS 和 Linux 也还没有——它们在路线图里,但还不在代码里。
为什么安装包有 100 MB,不是 55 MB?
便携版是 55 MB。每个安装包额外带上该语言的小模型,这样第一次启动就已经离线可用,不必先下载 30–50 MB。
准确率到底如何?
取决于语言和模型,我们不想只给一个数字。小模型适合笔记和短句;大模型明显更好,但要加载一到两分钟。选好语言后,可以在设置里换大小。
需要显卡吗?
不需要。识别跑在 CPU 上。小模型约占 0.3 GB 内存、几秒就绪;大模型要几 GB 内存和约一分钟加载。
真的免费吗?
是的——Apache-2.0,无订阅、无付费、无广告。可选的模型同样来自 VOSK 项目,Apache 2.0 许可。
我的录音会怎么样?
不主动保存任何东西。文字转写写入文本文件,历史是用户目录里的 SQLite 文件。卸载程序、删掉目录,就什么都不剩。
Windows 提示未知发布者。
二进制文件暂未签名。首次运行时 SmartScreen 会警告:选择「更多信息」→「仍要运行」。源码在 GitHub,发布页上还有 SHA-256 校验和。
能在命令行里用吗?
可以。`VoxSpica.exe mic`、`VoxSpica.exe file meeting.mp3`、`VoxSpica.exe history --search "会议"`——命令行和窗口共用设置与历史。